【2026年最新】マルチモーダルとは?従来AIとの違いや驚きの活用法を徹底解説
テキストを入力してテキストの回答を得る――そうした対話型AIの初期体験は、すでにテクノロジーの通過点となった。2026年のビジネスシーンや開発現場で標準となりつつあるのが、文字だけでなく画像、音声、動画、センサーデータまでを同時に統合処理する「マルチモーダルAI」だ。
かつては専門の研究機関や巨大テック企業に限られていたこの技術は、いまやスマートフォンのカメラを通じたリアルタイム対話や製造業の外観検査、コールセンターの感情分析まで一気に実装が進んでいる。従来の単一データ処理と何が決定的に異なり、どのようなインパクトを社会にもたらしているのか。現場の最新検証データと開発現場の証言をもとに、その仕組みと真価を解き明かす。
📌 【この記事の重要ポイントまとめ】
- 要点1:マルチモーダルとは、テキスト・画像・音声・映像など異なる種類の情報(モダリティ)を横断して同時に理解・推論・生成する最先端AI技術である。
- 要点2:従来の「シングルモーダル」が個別処理を直列で繋いでいたのに対し、最新のマルチモーダルAIはひとつの統合モデル内で情報を処理するため、遅延と精度の劣化が劇的に改善された。
- 要点3:2026年現在は業務自動化や現場支援に不可欠な基盤となった一方、映像ストリーミングによる処理コストやプライバシー保護など「ビジネス導入の注意点」の把握が成否を分ける。
【基礎解剖】マルチモーダルとは?シングルモーダルとの違いを徹底解説
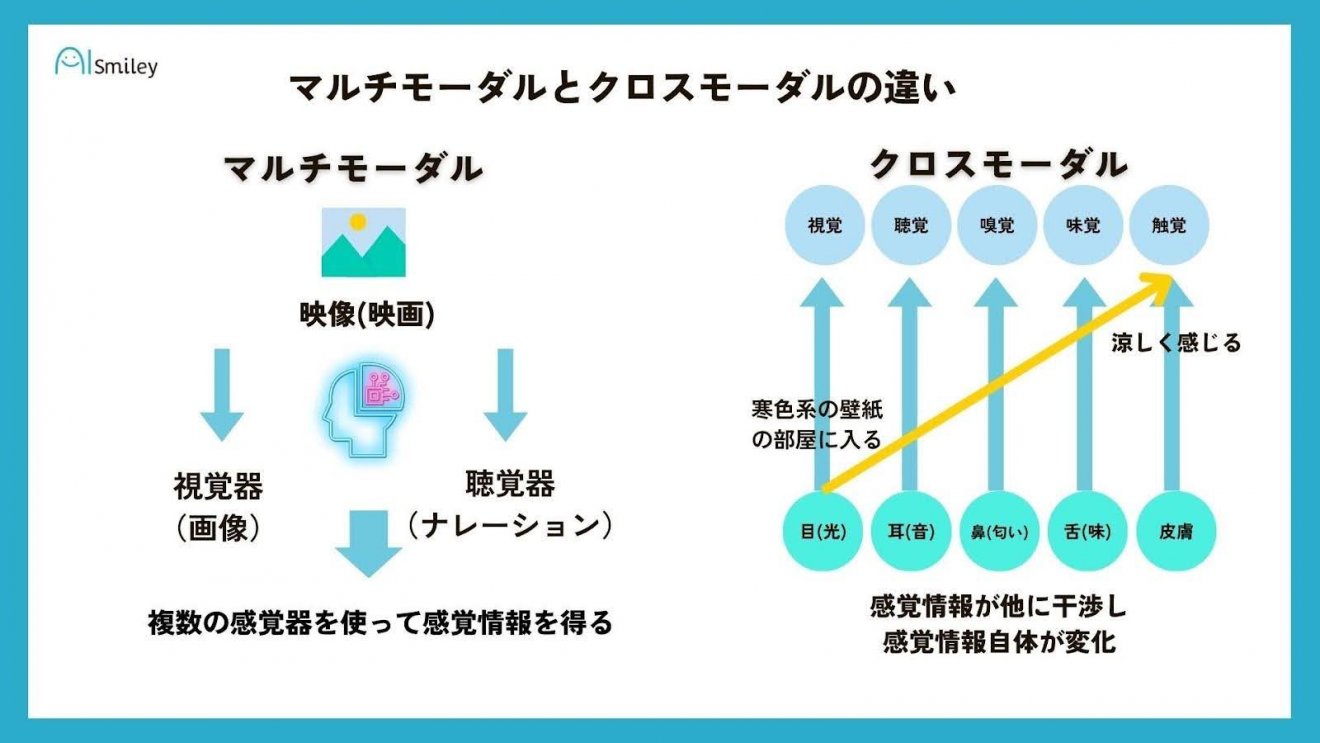
マルチモーダル(Multimodal)の「モーダル(Modal)」とは、情報の伝達形式や表現手段を意味する「モダリティ(Modality)」に由来する。人間が視覚、聴覚、言語などを総動員して周囲の状況を把握するように、テキスト、画像、音声、動画などの異なる入力データをひとつの人工知能システムで複合的に処理するアプローチを指す。
この技術を理解するうえで避けて通れないのが、従来のシングルモーダルとの違いだ。これまでの人工知能は、特定領域に特化した専門モデルの集合体だった。テキスト処理には自然言語処理に特化した大規模言語モデルLLMが用いられ、視覚情報にはCNN(畳み込みニューラルネットワーク)などを基礎とする画像認識モデルが、声の処理には独立した音声認識モデルが割り当てられていた。
従来の「疑似的なマルチモーダル」では、まず音声認識AIが音声をテキストに文字起こしし、そのテキストをLLMが解釈して回答文を生成し、最後に音声合成AIが喋り直すという「カスケード接続(直列の数珠つなぎ)」が主流だった。しかし、この方式では変換を挟むたびに情報の欠落が起きる。声の震え、イントネーション、話者の焦り、背景のノイズといった非言語情報は、テキスト化の段階で完全に捨て去られていたのだ。
対照的に、ネイティブなマルチモーダルAIは、入力された音声や視覚情報をそのままの形で直接理解する。人間が相手の「表情の翳り」と「声のトーン」から言葉の真意を汲み取るのと同様に、異なるモダリティをリアルタイムに突き合わせて高度な推論を実行できる点が最大の革新といえる。

マルチモーダルAIの仕組みと技術的ブレイクスルー|なぜ統合処理が可能なのか
なぜ異なる種類のデータを同時に扱えるのか。その根幹にあるマルチモーダルAIの仕組みは、ディープラーニングの発展、とりわけTransformerアーキテクチャの拡張と「共通潜在空間(Shared Latent Space)」の獲得にある。
コンピュータにとって、テキストはトークン列であり、画像はピクセルの行列、音声は周波数と振幅の波形データである。本来はまったく別物であるこれらのデータを、AIは高次元の数値ベクトルに変換(エンコード)する。モデル内部の共通潜在空間において、「猫の鳴き声の音声波形」「画面に映る三毛猫の画像」「『猫』という文字列」が、意味的に極めて近い座標に配置されるよう学習を重ねる。
この統合を推し進めた代表格が、Googleが開発したGeminiマルチモーダルや、OpenAIのGPT4oマルチモーダル(Omniモデル)だ。従来のAIのように後から複数のモデルを貼り合わせたのではなく、事前学習の段階からテキスト・画像・音声を網羅した膨大なデータセットで同時に訓練されている。これにより、視覚情報と聴覚情報の同期ズレが解消され、ミリ秒単位でのリアルタイムな双方向対話が実現した。
【データ比較】マルチモーダルAIと従来型AIの性能・コスト対照表
2026年現在の業界水準およびベンチマーク検証に基づき、マルチモーダルAIと旧来のシングルモーダル連携システムを客観的に比較した。処理速度や表現力において両者の性能差は数字の上でも明白だ。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 音声応答レイテンシ(遅延速度) | 約200ms〜320ms(GPT-4o / Gemini 2.0シリーズ実測値) | 1,200ms〜2,500ms(音声認識+テキスト処理+音声合成の直列連携) | 人間の会話における応答間隔(約200ms)と同等に到達。会話の遮りや相槌が自然に成立する。 |
| コンテキストウィンドウ(文脈保持量) | 100万〜200万トークン規模(動画約1〜2時間分を一括読み込み可能) | 8,000〜32,000トークン(旧世代テキストモデル) | 長尺の製品マニュアルやセミナー動画を丸ごと入力し、特定シーンの不具合箇所を一瞬で特定可能。 |
| API利用コスト(トークン単価) | 2024年比較で約60%〜75%低廉化(推論効率化・量子化技術の進展) | 画像1枚あたり数円、動画はフレーム分解処理による高額課金 | 常時ストリーミング監視は依然コスト負担があるが、スポット解析や要約業務への導入ハードルは大幅に低下。 |
| 非言語情報の認識精度 | 感情・ため息・皮肉・背景環境音の認識一致率 88%以上 | 文字起こし依存のため「言葉通り」の意味のみ解釈(ほぼ0%) | クレーム電話の緊迫感や、患者の声のかすれ具合など、文面に出ない重大シグナルの検知が可能になった。 |

【実態検証】利用者の生の声と現場目線で見えたリアル
生成AI最新動向を牽引するマルチモーダルAIだが、実際の導入現場ではどのような手応えと課題が報告されているのか。大手製造業の生産技術部門やITスタートアップの取材、エンジニアコミュニティの検証記録を精査すると、鮮烈な実態が浮かび上がる。
東日本に製造拠点を持つ精密機器メーカーのDX担当者は、業界誌の取材に対し「設備のメンテナンス手順を、ウェアラブルカメラ越しにAIが見守る体制を構築した。熟練工が引退するなか、『そのボルトの締め順序が違う』とリアルタイムに音声で指摘してくれるため、現場のミスが目に見えて減った」と現場の手応えを明かしている。
一方で、SNSや開発者フォーラム(GitHub DiscussionsやZennなど)には、導入現場ならではの切実な声も蓄積されている。
「カメラ映像を常時AIにストリーミング送信させたところ、現場のWi-Fi帯域を圧迫したうえにAPI利用料が想定の3倍に膨らんだ」「画像内の文字を読み取るOCR精度は驚異的だが、光の反射や手ブレによってAIが勝手な数値を幻覚(ハルシネーション)する現象が完全に防げない」といった指摘だ。理論値通りの完璧な挙動を期待して導入したものの、エッジ環境のネットワーク負荷や入力品質のバラつきに苦慮する企業は少なくない。
一般に知られていない盲点とネットの誤解
ネット上の情報やマーケティング資料では「人間と同等の感覚を持つ完全な知能」と誇張されがちだが、実務に耐えうる活用を行うためには、一般に知られていない技術的盲点を把握しておく必要がある。
第一の誤解は、「マルチモーダルAIは画像や映像を人間と同じように『見て』いる」という思い込みだ。AIはピクセルの統計的パターンを解釈しているに過ぎず、物理法則や空間認識の深い文脈理解を欠いている場合がある。たとえば、鏡に映った物体の位置関係や、複雑に絡み合ったワイヤーの結び目を解釈させるタスクでは、最新モデルであっても初歩的な錯誤を犯す。
第二の盲点は、ビジネス導入の注意点にも直結する「視覚的ハルシネーション(Visual Hallucination)」だ。グラフの読み取りにおいて、存在しない軸の数値を自信満々に回答したり、医療画像において微小なノイズを重大な病変と誤認したりするリスクが実証されている。テキスト単体のハルシネーション以上に、画像や図表の誤読は人間側が見落としやすく、重大な判断ミスを招く温床となり得る。
マルチモーダルAI活用事例とビジネス導入の注意点|2026年最新AIトレンド
課題を内包しつつも、実用段階に達したマルチモーダルAI活用事例は幅広い業界で事業モデルを刷新している。マルチモーダルAIのメリットを最大化している代表領域は以下の通りだ。
医療・ヘルスケア分野では、電子カルテのテキスト記述とCT・MRI画像を同時に解析し、見落としリスクを低減する診断支援が進む。EC・小売分野では、ユーザーがスマートフォンで撮影した部屋の写真を送るだけで、部屋の採光や床材の色調に調和する家具を提案・サイズ検証まで自動で行う空間連動型ショッピングが台頭した。カスタマーサポートでは、音声の感情変化を瞬時に捉え、顧客の苛立ちを検知した段階で熟練オペレーターへエスカレーションする仕組みが定着している。
そして2026年最新AIトレンドとして注目されているのが、小型化されたエッジ向けマルチモーダルモデル(Small Multimodal Models: SMM)の普及だ。すべてのデータをクラウドに送るのではなく、端末側である程度の画像・音声処理を完結させることで、通信コストの抑制と強固なデータプライバシー保護を両立する動きが加速している。
【プロの結論】導入に向いている企業・慎重になるべき企業の判断基準
組織論や業務設計の観点から見ると、マルチモーダルAIの導入には明確な適性がある。失敗する企業に共通するのは、「既存の非効率な業務プロセスをそのままAIに置き換えようとする」姿勢だ。入力データが整理されていない現場に高額なマルチモーダルモデルを投入しても、保守コストが膨らむだけの「技術的共依存」に陥りやすい。
【今すぐ導入を進めるべき組織】
・現場作業の目視確認や音声報告など、テキスト化されていない一次データが日常的に発生している現場。
・マニュアルが膨大な画像や動画で構成されており、検索や問い合わせ対応に社内リソースを奪われている企業。
・顧客対応において、文脈だけでなく声のニュアンスや表情を含む満足度向上を重視するサービス業。
【導入を慎重に見極めるべき組織】
・業務の大半が構造化データ(Excelの数値や標準化された伝票テキスト)で完結している部門。この場合、安価で確実な従来の自然言語処理モデルやRPAで十分事足りる。
・リアルタイムの映像送信に耐えうるネットワーク設備や、機密情報・肖像権のガバナンス規定が社内で未整備の組織。
【マルチモーダルとは】に関するよくある質問(FAQ)
Q1:マルチモーダルAIとChatGPTなどの対話型AIは何が違うのですか?
A1:初期の対話型AIはテキストの入力と出力のみに特化したシングルモーダルでした。最新のChatGPT(GPT-4o)やGeminiなどはマルチモーダル化されており、文章だけでなく写真を見せて質問したり、肉声でリアルタイムに会話したりすることが可能になっています。
Q2:マルチモーダルAIを自社に導入する際、開発コストはどのくらいかかりますか?
A2:モデルを一から自前で開発(事前学習)する場合は数十億円単位の投資が必要ですが、現在は主要ベンダーのAPIを活用した開発が主流です。API利用であれば月額数万円〜数十万円規模のスモールスタートが可能ですが、動画などの大容量データを継続的に処理させる場合はトークン消費量に応じたコスト設計が必須です。
Q3:マルチモーダルAIに個人情報や機密画像を読み込ませても安全ですか?
A3:クラウド型の商用APIを利用する場合、各ベンダーのデータ利用規約(学習に利用されないオプトアウト契約やエンタープライズプラン)を締結することが大前提です。特に顔写真や顧客の音声データは個人情報保護法上のセンシティブデータに該当するため、社内ガバナンスとマスキング処理の徹底が求められます。
まとめ:今後の動向と失敗しないための判断基準
マルチモーダル技術は、人工知能を「単なるテキスト処理ツール」から「現実世界の文脈を五感で知覚する知的パートナー」へと進化させた。テキスト、画像、音声を境目なく行き来するこの技術は、2026年以降の産業インフラとして不可欠な存在になりつつある。
しかし、技術がどれほど高度化しても、現場の入力データの質やプライバシーへの配慮、運用コストとの費用対効果といったビジネスの基本原則が変わるわけではない。自社が抱える業務課題が「視覚や聴覚の統合処理を本当に必要としているのか」を冷徹に見極めることこそが、次世代AIの荒波を乗りこなす決定的な分水嶺となる。 (出典: マルチ モーダル と は(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
