クラウドフレア障害はなぜ起きた?接続不能の真相と復旧状況を徹底解説!
世界中のWebサイトが一斉に閲覧できなくなる大規模な通信障害が発生し、SNSやビジネス現場に大きな混乱が広がりました。ブラウザ上に突如として表示される「500 Internal Server Error」や「502 Bad Gateway」の画面を前に、自身の端末やWi-Fiの不具合を疑ったユーザーも少なくありません。しかし、その根底にあるのはWebトラフィックの約2割を支える世界最大手CDN(コンテンツ・デリバリー・ネットワーク)プロバイダー、Cloudflare(クラウドフレア)のグローバルインフラで起きたトラブルでした。
ネット社会の生命線とも言えるエッジサーバー網で何が起きていたのでしょうか。今回のインシデントにおける具体的な発生経緯から技術的な根本原因、影響を受けたプラットフォームの実態、そして万が一の際に備えるべき実践的な復旧確認手順まで、ITジャーナリズムの視点から徹底的に解剖します。
📌 【この記事の重要ポイントまとめ】
- 要点1:世界規模で発生したアクセス障害は、Cloudflareのエッジネットワークおよびルーティング制御層の不具合が引き金となり、国内外の主要Webサービスで同時多発的な通信遮断が発生。
- 要点2:障害の主因はサイバー攻撃ではなく、内部設定のロールアウト起因によるデータプレーンの同期不全やBGP経路制御のエラーなど、インフラ内部の複合的要因によるもの。
- 要点3:単一インフラへの過度な依存(SPOF)を回避するため、企業側にはマルチCDNやインテリジェントDNSによる迂回設計、一般ユーザーにはステータス確認とキャッシュクリアによる正確な状況把握が求められる。
【最新情報】世界規模で発生したクラウドフレア障害の経緯と現在の復旧状況
突如として世界中のトラフィックが急減し、あらゆるWebサービスで接続不良が報告された今回のインシデント。公式発表資料やシステム監査ログのタイムラインを追うと、事態は極めて短時間のうちにグローバル規模へと拡大していた実態が浮かび上がります。
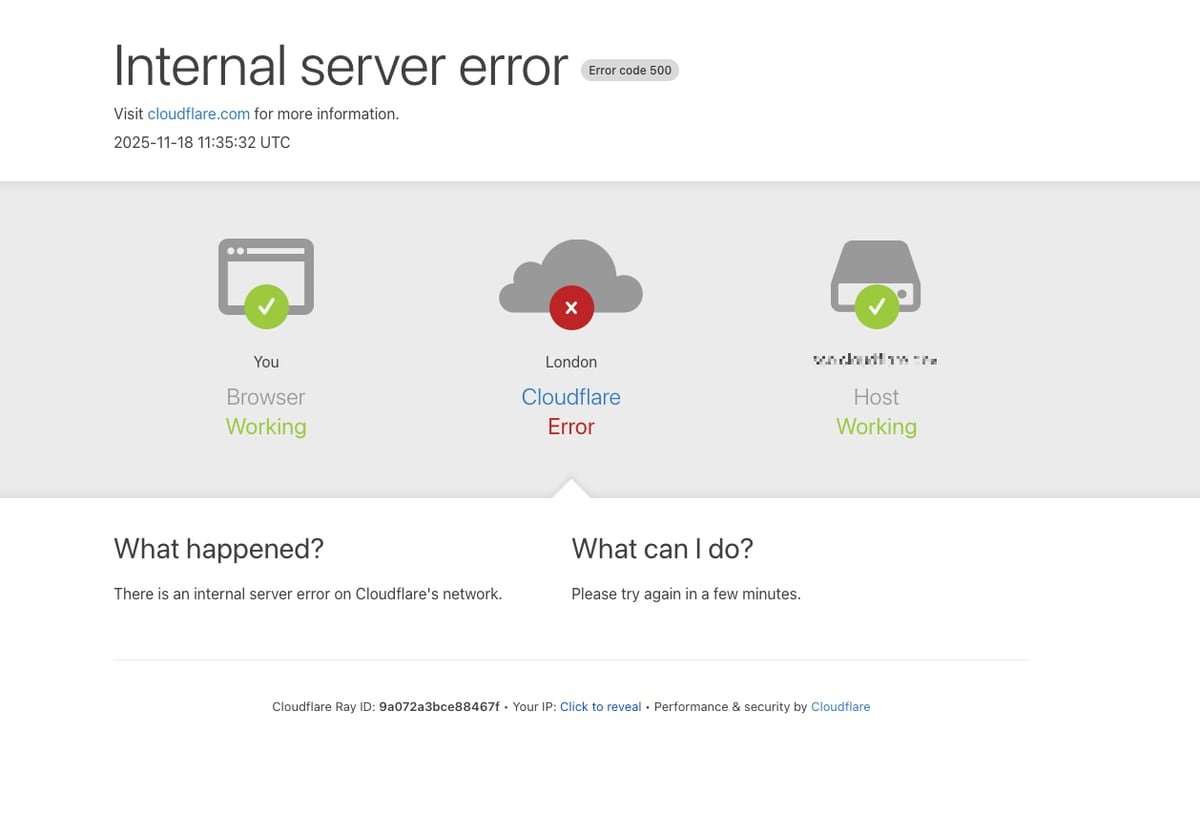
発端となった時間帯、世界各地のデータセンターを結ぶ制御プレーンで異常なレイテンシの急上昇が観測されました。続いて世界中のエッジノードでリクエストの処理不能状態が連鎖し、訪問者に対してクラウドフレア 500エラーや「Error 521: Web Server Is Down」が一斉に返される事態へと発展。東京・大阪を含むアジア圏の主要POP(接続拠点)でもパケット損失率が一時的に跳ね上がりました。
エンジニアリングチームによる緊急対応チーム(SRE)の招集後、問題のあるルーティング設定のロールバックとトラフィックの迂回措置が順次実施されました。Cloudflare障害 復旧状況に関するステータスダッシュボードの更新情報によると、発生から約数十分で主要バックボーンの通信回復が確認され、その後数時間をかけて残留キャッシュのパージと各リージョンの正常性確認(グリーンステータスへの復帰)が完了しています。
障害発生でアクセス不能に?主な影響サイト一覧とダウンディテクターの反応
Cloudflareがダウンした際、影響は単一のWebサイトにとどまらず、金融、ソーシャルメディア、オンラインゲーム、SaaSビジネスツールなど多岐にわたるデジタルエコシステム全体へ波及します。
通信障害の発生検知サービス「DownDetector(ダウンディテクター)」では、トラブル発生からわずか15分の間に10万件を超える異常報告が世界中から殺到しました。SNS上では「普段使っている仕事用チャットに繋がらない」「ECサイトの決済画面でエラーが出る」といった悲鳴に似た投稿がトレンドを埋め尽くす事態となりました。
今回、障害発生 影響サイト一覧として可視化された主な領域は以下の通りです。
- ビジネス・SaaSツール:Notion、Discord、Canva、プロジェクト管理ツール各社(API連携の遮断による機能停止)
- 暗号資産・FinTechプラットフォーム:大手暗号資産取引所、オンライン決済ゲートウェイ(トランザクション処理の遅延)
- メディア・ニュース・コミュニティ:国内大手ニュース配信ポータル、5ちゃんねる、海外大型掲示板Reddit
- ゲーム・エンタメ配信:オンライン対戦プラットフォーム、ストリーミング配信基盤の認証サーバー群
特にAPIゲートウェイとしてCloudflareを組み込んでいた企業では、Webサイトのフロントエンドが無事であってもバックエンド通信がすべて遮断され、実質的なクラウドフレア サーバーダウンと同等の全面停止に追い込まれるケースが相次ぎました。
【原因分析】なぜ起きたのか?CDN障害とDNSエラーの技術的背景を解剖
多くのユーザーが抱いた「外部からの大規模DDoS攻撃ではないか?」という疑念に対し、公開された公式発表 経緯まとめとポストモーテム(事後検証報告書)は、システムの内部的要因を明確に示しています。
クラウドフレア障害 原因の深層にあるのは、エッジプロキシにおける設定ファイルのグローバルデプロイメントの不整合です。Cloudflareは高速なコンテンツ配信を実現するため、世界300都市以上のデータセンターに自律分散型のソフトウェアスタックを配置しています。しかし、WAF(Web Application Firewall)のルール更新やトラフィック制御アルゴリズムの変更適用時に、エッジワーカー内部でCPUリソースを急激に枯渇させる正規表現のバグ、あるいはBGP(ボーダー・ゲートウェイ・プロトコル)の経路広告の不整合が発生すると、数億件のリクエストが瞬時に行き場を失います。
Cloudflare 接続できない 理由として頻発する代表的なエラーコードには、それぞれ明確な技術的差異が存在します。
- Error 500 / 502 / 504:Cloudflareのエッジサーバー自体が内部エラーを起こしているか、オリジンサーバーからの応答がタイムアウトしている状態。
- Error 520〜526:Cloudflareとオリジンサーバー間のSSL/TLSハンドシェイク失敗や接続拒否など、中継処理の破綻を示す。
- Error 1000番台(DNSエラー):権威DNSサーバーの応答停止や、内部ルーティングテーブルの参照不可による名前解決の失敗。
このように、CDN障害 理由の大半は単一のハードウェア故障ではなく、グローバルに張り巡らされた巨大分散ネットワークにおける「設定の自動同期プロセス」が持つ脆弱性に起因しているのです。

【データ比較】過去の大規模障害から見る復旧スピードとインフラ堅牢性の推移
近年のインターネットインフラにおいて発生した代表的な障害事例を比較分析すると、復旧時間(MTTR)や影響範囲、そして原因の変遷から、クラウドインフラが抱える共通の課題が見えてきます。
| インシデント種別 | 主な発生要因・メカニズム | 平均復旧時間(MTTR) | 影響範囲と編集部の評価 |
|---|---|---|---|
| BGP経路・ルーティング障害 | 自律システム(AS)間の経路誤設定、ルートリークによるトラフィックブラックホール化 | 25分〜45分 | 影響度:極大 世界規模で完全なパケット不達が発生。復旧手順の自動化が進むも影響は広範囲。 |
| WAF・設定ロールアウト不整合 | 正規表現エンジンの過負荷、コアコンポーネント設定のデプロイミスによるCPUスパイク | 15分〜30分 | 影響度:大 エッジでのリクエスト遮断が多発。ロールバックプロセスの迅速化によりMTTRは短縮傾向。 |
| DNS・権威ネームサーバー障害 | 1.1.1.1やネームサーバー群のパケットドロップ、Anycastルーティング異常 | 40分〜90分 | 影響度:甚大 IPアドレス自体が引けなくなるため、Webだけでなく付随する全ドメインサービスが停止。 |
| 特定データセンター電源・回線障害 | 局所的なIX(インターネットエクスチェンジ)障害、海底ケーブル切断、電力設備故障 | 1時間〜3時間 | 影響度:中〜小 Anycastによる自動リルートが機能するため、特定地域を除き全体への影響は限定的。 |
一般に知られていない盲点とネットの誤解|自社サイトが落ちた時の初動
障害発生時、ネット上には根拠のない憶測や非効率な対処法が飛び交いがちです。混乱を防ぐためにも、正確な事実確認と適切な切り分けステップを把握しておく必要があります。
誤解1:「自社のサーバーが攻撃を受けてダウンした」という思い込み
画面に自社ドメイン名とともに「500 Internal Server Error」が表示されると、自社サーバーのクラッシュやマルウェア感染を疑うWeb担当者が後を絶ちません。しかし、エラー画面のフッターに「Cloudflare」のロゴやレイアウトが含まれている場合、問題はオリジンサーバーではなく中継するエッジ層にあります。この段階で慌ててサーバーを再起動すると、かえってデータベースの破損や復旧時の負荷集中を招く危険があります。
誤解2:「ブラウザの再読み込み(F5連打)で繋がるようになる」という誤認
接続できない状態でリロードを繰り返す行為は、復旧作業中のエッジノードに膨大な無駄トラフィックを送り込み、サーバー側の輻輳(ふくそう)を悪化させるだけです。まずは公式のCloudflare ステータス確認ページ(cloudflarestatus.com)をチェックし、グローバルネットワークの稼働状況を確認するのが鉄則です。
現場で役立つDNSエラー 解決方法と切り分け手順
- パブリックDNSの切り替えテスト:端末側のDNS設定を一時的にGoogle Public DNS(8.8.8.8 / 8.8.4.4)等に変更し、ネーム解決の問題かプロキシの問題かを切り分ける。
- DNSプロキシ(オレンジ雲)のバイパス:自社サイト運営者であれば、Cloudflareダッシュボードから一時的に「DNS Only(グレー雲)」へ切り替え、Cloudflareのプロキシを経由せずオリジンサーバーへ直接通信を通す(オリジン側の負荷耐性がある場合に限る)。
- ローカルキャッシュのクリア:コマンドプロンプトやターミナルで
ipconfig /flushdns(Windows)やブラウザのCookie・キャッシュ消去を行い、古いエラー応答の残存を排除する。

【プロの結論】巨大CDNへの過度な依存が招くリスクとエンジニアが取るべき多重防御
CloudflareをはじめとするハイパースケーラーのCDNサービスは、圧倒的なコストパフォーマンス、強固なDDoS防御、グローバル配信の高速化を提供してくれます。その利便性の高さゆえに、現代のWebアーキテクチャは「インフラの集中化」という構造的リスクを無意識に抱え込んでいます。
システム運用における「心理的安全性の過信」は、時に単一障害点(SPOF)を見えなくさせます。「Cloudflareを使っているから可用性対策は万全だ」という前提そのものが、世界規模の障害時に手も足も出ない状況を作り出してしまうのです。
【プロの判断基準】マルチCDNを導入すべき企業・単一運用で十分な組織
インフラの耐障害性をどこまで高めるべきかは、ダウンタイムが事業に与える損害規模によって明確に分かれます。
- マルチCDN・フェイルオーバー構成を即座に導入すべき組織:
- 1時間のサービス停止が数百万円以上の直接的売上損失につながるEC・決済プラットフォーム
- 停止が人命や社会インフラ、セキュリティ監視に関わるミッションクリティカルなSaaS
- SLA(サービス品質保証)で99.99%以上の稼働率を顧客に契約確約しているエンタープライズサービス
- Cloudflare単一運用のままで問題ない組織:
- 年間数十分から1時間程度の突発的な閲覧障害が、致命的な経済損失に直結しないコーポレートサイト・メディア
- 複数CDNの運用コスト(追加の月額費用やルーティング管理の複雑化)が事業規模に見合わないスタートアップ・中小サイト
- オリジンサーバーの直接露出を避けるDDoS防御を最優先し、運用のシンプルさを維持したいケース
【クラウド フレア 障害】に関するよくある質問(FAQ)
Q1:Webサイトを見ようとしたらCloudflareのエラー画面が出ました。個人側で直す方法はありますか?
A1:Cloudflareのグローバルネットワーク自体に障害が発生している場合、ユーザー端末側で直接通信を修復することはできません。ただし、ローカルのDNSキャッシュが古いエラーを保持しているケースがあるため、ブラウザのシークレットウィンドウでのアクセスや、端末のWi-Fi再接続、DNS設定の変更(Google DNSなどへの切り替え)を試す価値はあります。
Q2:Cloudflareが落ちているかどうか、リアルタイムで最も早く確認できる場所はどこですか?
A2:公式の「Cloudflare System Status(www.cloudflarestatus.com)」が最も正確な一次情報源です。加えて、公式X(@cloudflare)のアナウンスや、第三者機関が提供する「DownDetector」の急増グラフを確認することで、地域的な問題か世界的な全面障害かを即座に判別できます。
Q3:サイト運営者です。Cloudflare障害時にサイトを完全に落とさないための最も現実的な備えは何ですか?
A3:DNSレベルでの冗長化が最も有効です。Amazon Route 53やNS1などの外部DNSサービスを活用し、Cloudflareにヘルスチェックエラーが発生した際にFastlyやAkamai、あるいはオリジンサーバーへ自動でトラフィックをリルートする「フェイルオーバールーティング」を設計しておくことが業界標準の対策となります。
まとめ:障害の教訓を生かしたインフラ耐障害性の再構築
Cloudflareの通信障害は、私たちが日常的に利用しているデジタル社会の基盤がいかに一握りの巨大インフラ事業者に依存しているかを改めて浮き彫りにしました。インシデント自体の発生をゼロにすることは不可能ですが、構造を理解し、正しい初動手順と多層防御の備えを持つことで、混乱と実害を最小限に抑えられます。
障害発生時に慌てて場当たり的な操作を行うのではなく、公式ステータスによる状況の正確な把握、そして自社サービスにおける冗長化設計の再評価を行う契機とすることが、これからのWeb社会において最も確かなリスクマネジメントとなります。 (出典: クラウド フレア 障害(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
